ホワイトボードの消えない文字を消す方法!消毒ジェルや身近なモノで復活させる裏ワザ
ポコぺん
ポコぺん LifeLog
ChatGPTをはじめとする生成AIの爆発的な普及や業務へのディープラーニング実装に伴い、企業や研究機関において「AIサーバー(GPUサーバー)」を調達・構築しようとする動きが急速に加速しています。
社内業務のDX化や独自AIモデルの開発、高精度なRAGシステムの運用など、自社専用の計算インフラを整備することは、今や企業の競争力を左右する最重要戦略の一つです。
しかし、従来のWebサーバーやデータベースサーバーと同じ感覚でAIサーバーを調達しようとすると、導入現場では壊滅的なトラブルに直面します。
「契約電源容量を瞬時にオーバーしてブレーカーが落ちた」「購入した最先端GPUの性能がネットワークのボトルネックで半分も出ない」「ファンの爆音と猛烈な排熱でオフィスの空調が機能不全に陥った」といった失敗談が後を絶ちません。
AIサーバーは、従来の汎用サーバーとはアーキテクチャの根本思想から電力要件、冷却方式、通信速度に至るまで次元が全く異なる特殊な計算基盤です。
本記事では、AIサーバーと通常サーバーの本質的な違いを解き明かし、調達やファシリティ設計で絶対に失敗しないための必須基礎知識5選を体系的に解説します。
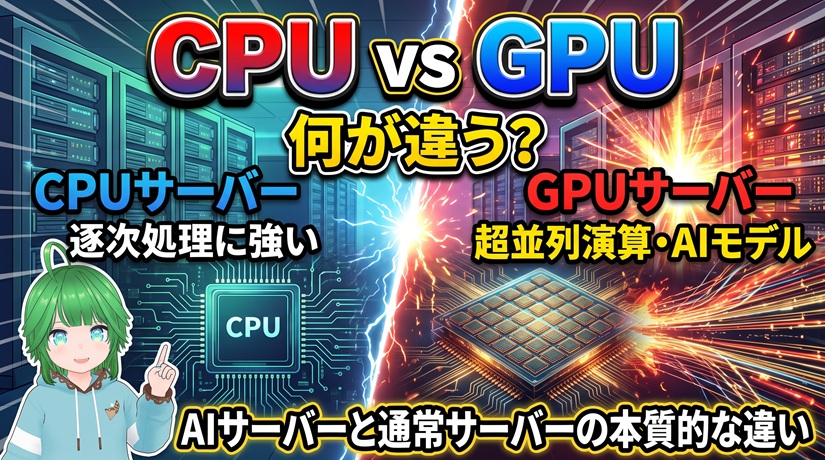
従来の汎用サーバーの中核であるCPU(Central Processing Unit)は、複雑なビジネスロジックの評価、条件分岐、シーケンシャル(逐次)なトランザクション処理をいかに低遅延で高速に実行するかを追求して設計されています。
数十個の高性能コアと大容量キャッシュメモリを備え、OSの制御やWebリクエストのハンドリング、データベースの入出力を柔軟に統括するのが得意分野です。
しかし、CPUは高度な汎用性を持つ反面、同じ単純な計算を同時に数万〜数億回繰り返すような処理に対しては物理的なコア数が決定的に不足しています。
大量の行列演算を必要とするディープラーニングのモデル計算をCPUだけで行おうとすると、膨大な計算時間と電力を消費してしまいます。
これに対してAIサーバーの主役であるGPU(Graphics Processing Unit)やNPU(Neural Processing Unit)は、大規模なテンソル計算や行列積と呼ばれる単純な並列演算を処理することだけに特化して作られた専用プロセッサです。
1基のチップの中に数千から数万もの小さな演算コアが集積されており、膨大なデータを一斉に並列処理します。
最新のハイエンドAIサーバー(NVIDIA H100やBlackwell B200搭載機など)では、1台のシャーシに4〜8基以上のGPUが搭載され、それらの間が毎秒数百ギガバイトの超高速インターコネクトで直結されています。
これにより、ペタフロップス(PFLOPS)級の圧倒的な演算密度を実現しています。
大規模言語モデル(LLM)の推論や学習において、計算コアと同じくらい致命的なのが「メモリ帯域幅」です。
数千億のパラメータを瞬時にメモリから演算ユニットへ転送し続けなければ、GPUコアがデータを待って空転してしまいます。
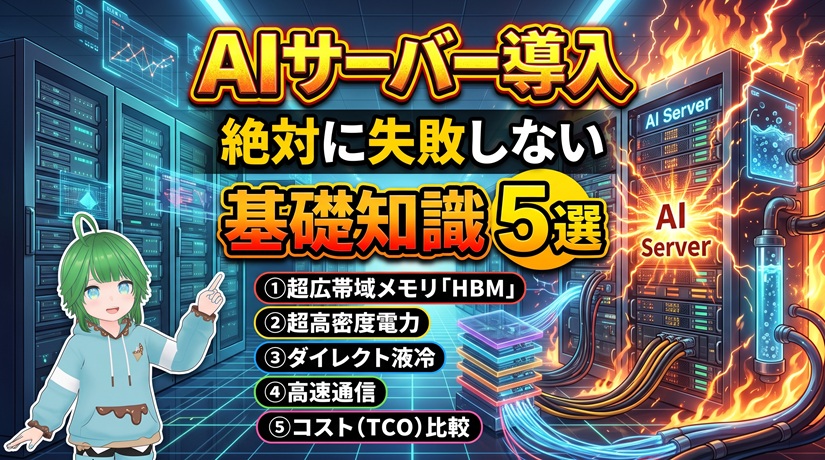
通常サーバーのDDR5メモリが数百GB/sであるのに対し、最先端AIサーバーは積層メモリ「HBM(High Bandwidth Memory)」を採用し、毎秒数TB(テラバイト)という桁違いの転送速度を誇ります。
通常の2U汎用サーバーは1台数百ワット程度で、1ラック(42U)に満載しても5kW〜10kWの受電で運用できます。
しかしハイエンドAIサーバーは1台だけで3.5kW〜10kW近い電力を消費します。
サーバーを数台並べただけで従来型ラックの供給電力を使い切るため、3相200V/400Vのダイレクト給電や特別高圧受電設備、大容量PDUの事前工事が不可欠となります。
莫大な電力消費はそのまま巨大な熱エネルギーへと変換されます。
GPUから発生する熱量はもはや従来の空冷ファンの風量では冷却しきれず、熱暴走を防ぐためにクロック周波数が強制低下するサーマルスロットリングを引き起こします。
そのため、チップの上に冷却液プレートを直結して熱を奪う「ダイレクト・ツー・チップ(DLC)液冷」や、特殊な絶縁オイル槽にサーバーごと沈める「浸漬冷却」への移行が急速に進んでいます。
複数台のAIサーバーを連結して大規模モデルを学習させる場合、サーバー間で重みパラメータや勾配(グラディエント)をミリ秒単位で同期させる必要があります。
一般的な10GbEや25GbEのLANでは通信速度が遅すぎてGPUが待ちぼうけを食らいます。
そのため、400Gbps〜800Gbpsの超低遅延を誇るInfiniBandや、イーサネット上でRDMA通信を行うRoCEネットワークの導入が必須となります。
AIインフラの導入には、数千万円〜数億円規模のハードウェア購入費だけでなく、電気代、データセンターのフロア費用、保守費用を含む「TCO(総所有コスト)」の試算が欠かせません。
短期の検証やPoCならクラウドGPU(AWSやAzure、GPU専業クラウド)が柔軟ですが、24時間365日フル稼働させる大規模学習では、長期的にオンプレミスの方がコストパフォーマンスに優れます。
検証はクラウドで行い、定常運用を自社インフラに移行するハイブリッド戦略が現実的です。
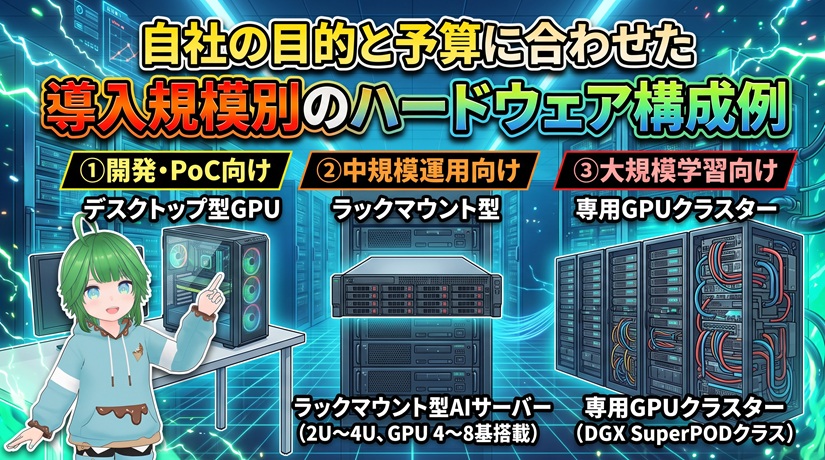
小規模なモデル検証やプロトタイプ開発、社内RAGの実験などを行う場合は、オフィスや研究室の100V〜200Vコンセントで動作するタワー型のGPUワークステーション(NVIDIA RTX 6000 Adaなど1〜2基搭載)からスタートするのが最適です。
データセンターの特殊な冷却設備や高圧受電工事を必要とせず、スピーディに開発に着手できます。
社内共通の推論APIサーバーや、中規模オープンモデルの追加学習・ファインチューニングを行う場合は、データセンターに設置するラックマウント型(GPU 4〜8基搭載)が主軸となります。
冗長化電源と高効率エアフローの確保が前提となります。
独自のフロンティアモデルを一から事前学習する超大規模プロジェクトでは、数十台から数百台のGPUノードをInfiniBandで緊密に束ねた専用クラスターが必要です。
専用の液冷ファシリティとペタバイト級の超高速NVMeストレージがセットで要求されます。
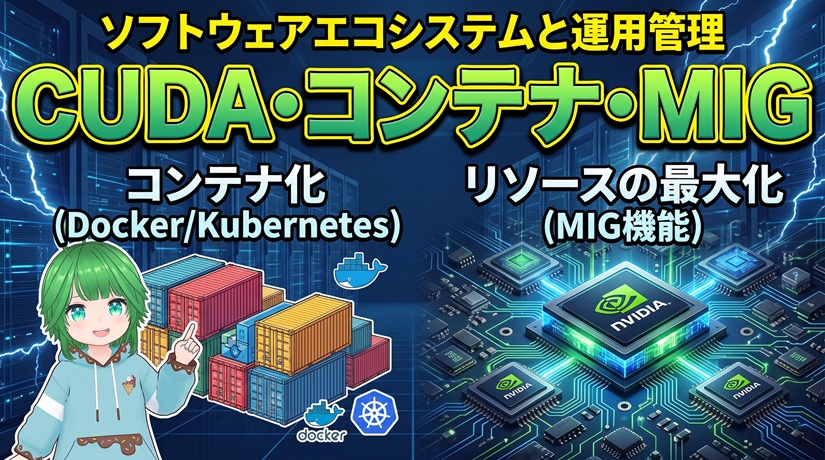
AI開発環境では、NVIDIAドライバ、CUDA、cuDNN、PyTorchやTensorFlowなどのフレームワークのバージョン相互依存関係が極めてシビアです。
OS上に直接環境を構築すると更新時にシステムがクラッシュするリスクが高いため、DockerやApptainerを用いたコンテナ化による環境の分離・ポータビリティの確保が鉄則となります。
高価なGPUを1つの軽量タスクで占有するのは極めて不経済です。
NVIDIAのMIG(Multi-Instance GPU)テクノロジーを活用すれば、1基の物理GPUをハードウェアレベルで最大7つの独立した仮想インスタンスに分割し、複数の開発者や異なるAPIリクエストに安全に割り振って稼働率を最大化できます。
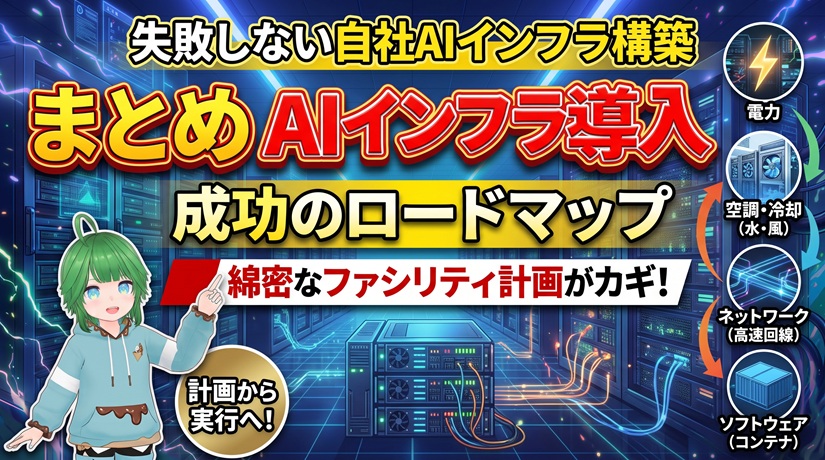
AIサーバーの導入は、単なる高性能PCの買い替えではなく、電力・空調・ネットワーク・ソフトウェアを包括した総合的なインフラエンジニアリングプロジェクトです。サーバー単体の計算スペックだけに目を奪われ、ファシリティ側の受け入れ能力を見落とすと、莫大な投資が無駄になってしまいます。
自社が解きたい課題の規模感を正確に見極め、まずは小規模なPoCやクラウドとのハイブリッド構成から段階的にステップアップしていくことが、失敗を防ぐ確実なロードマップです。今回解説した5つの基礎知識を社内の検討会議に活用し、盤石なAIインフラ基盤を構築してください。